RnD Café ☕️ – #444
12 septembre 2026
Au sommaire cette semaine
Lecture : 18 minutes – Expresso audio : 6 minutes
- L’édito : le prix de l’IA baisse, la facture non
- Token to token : le CV, puis l’achat, passent de machine à machine
- Vos données internes valent de l’or
- Les brèves de la semaine
RnD Ristretto
La synthèse du numéro, produite à partir des 704 sources de la semaine avec Gemini Notebook : à écouter en voiture, ou à parcourir en quelques slides.
La veille en podcast
Les slides
Le prix de l’IA baisse, la facture non
Par Alexis Rollin, RnD – Intelligence Appliquée
Bonjour à toutes et à tous.
AI Act, le règlement européen sur l’IA concrètement.
Lundi, en réunion conception avec un client, nous passions en revue un futur parcours en ligne incluant de petites capsules sonores (neuf « le saviez-vous » à écouter d’un clic). La voix de synthèse était une option plus rapide, et désormais impossible à distinguer d’une vraie voix.
Oui mais voilà, depuis le 2 août, l’AI Act impose que les sons générés par une IA soient marqués comme tels, et que donc nous allions indiquer « voix générée par IA » à côté du bouton.
La réponse n’a pas tardé : « ça tue le côté proximité ». Et au regard de sa cible et du contexte… compliqué. Elle fera donc enregistrer les textes par les comédiens avec lesquels elle travaille.
En résumé, l’option la moins chère n’a pas été retenue et clairement, ici, c’est le bon choix.
Ce petit arbitrage tombe en plus la semaine où le prix de l’IA s’effondre.
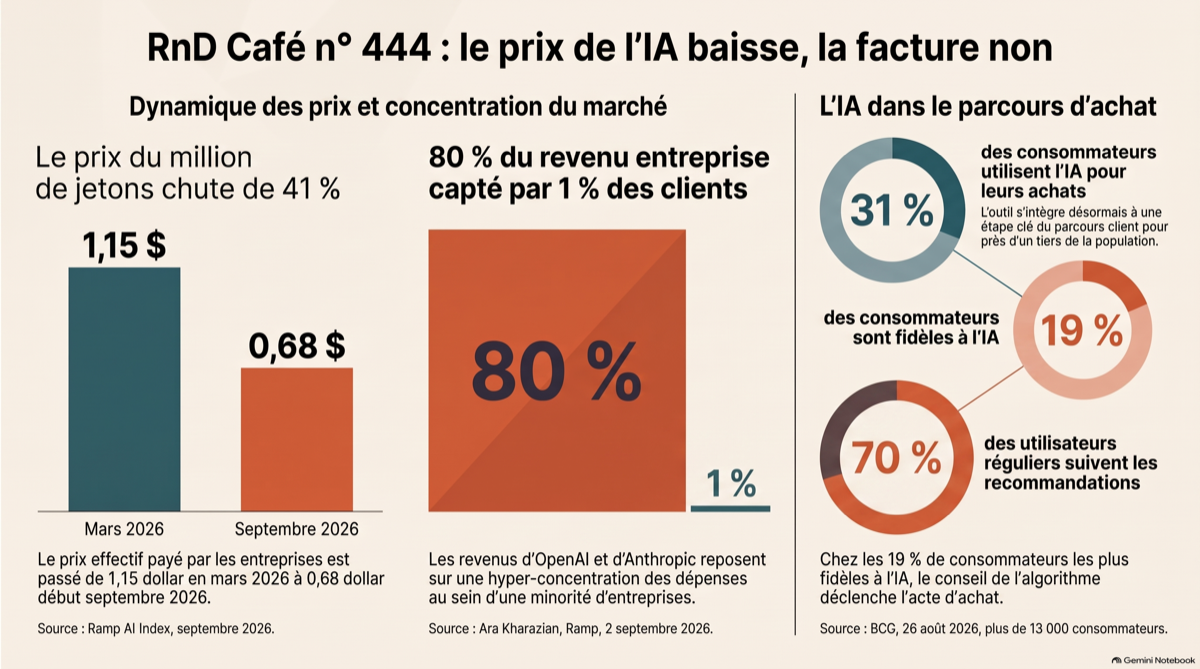
Selon Ramp, la société américaine qui fournit aux entreprises des cartes de paiement professionnelles et le logiciel qui suit ces dépenses, et qui publie chaque mois, à partir des factures réelles de ses clients, un indice de leurs dépenses d’IA, le prix effectif du million de jetons est tombé à 0,68 dollar, 41 % de moins qu’en mars.
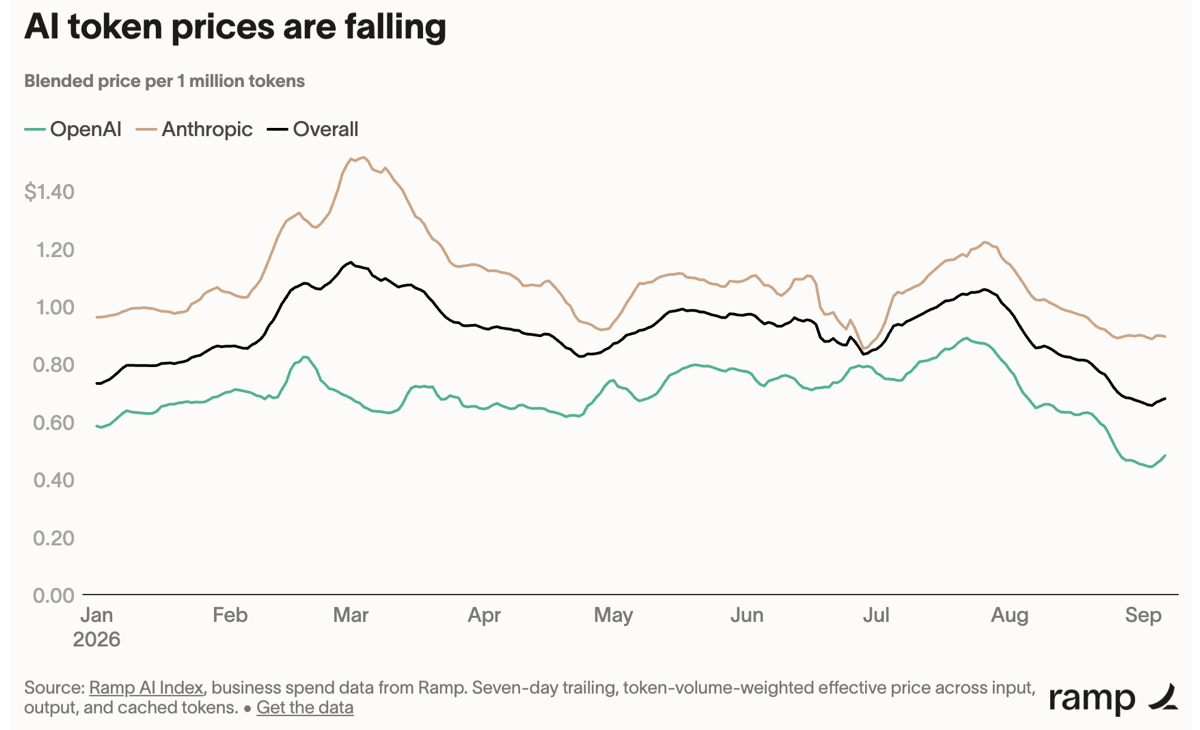
OpenAI a baissé de 80 % le prix de son modèle Luna, et l’usage a été multiplié par dix environ, a expliqué sa directrice financière. Et un modèle chinois ouvert, DeepSeek V4.1 Flash, obtient 98 % de la note d’Astra (sorti la semaine dernière) sur des tâches de design pour 1,4 % du coût, selon le classement OpenDesign Arena, tenu il est vrai par un éditeur d’outils de design.
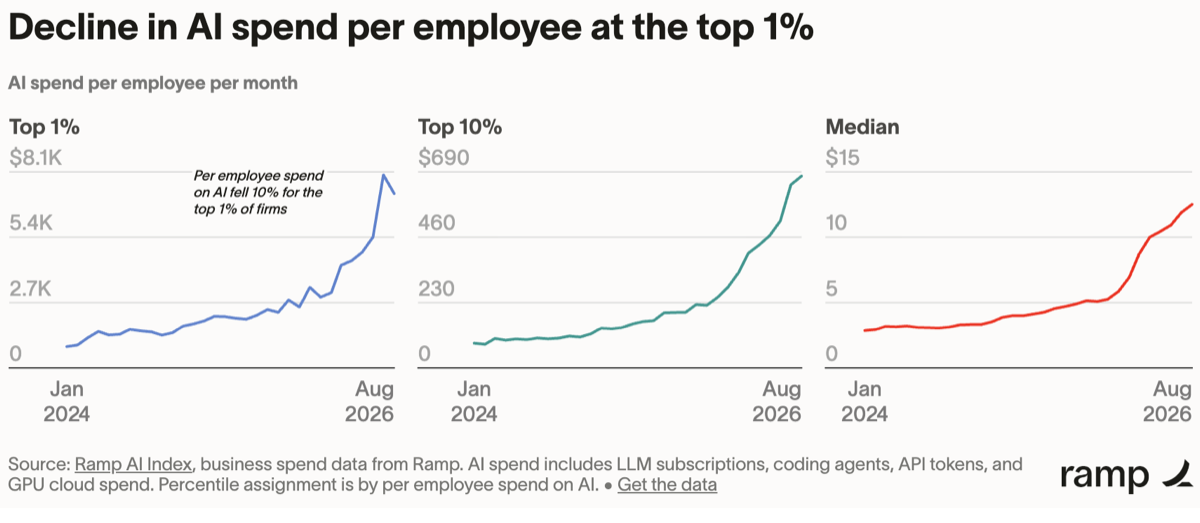
Et pourtant, en août, les entreprises clientes de Ramp qui dépensent le plus ont réduit leur dépense d’IA par salarié de 9,7 %. Ramp avance lui-même une explication d’été, les ingénieurs en vacances, mais titre sa lettre « des fissures dans la thèse de l’IA ». Et son économiste relève, d’après les dépenses de ces mêmes clients, que 80 % du revenu entreprise d’OpenAI et d’Anthropic vient de 1 % de leurs clients.
Et donc ? La question n’est plus le prix.
Au printemps, Uber a épuisé en quatre mois son budget IA de l’année, et son directeur des opérations reconnaissait, à propos du lien entre cette dépense et ce que l’entreprise produit :
« That link is not there yet », ce lien n’existe pas encore.
Brian Solis, qui dirige l’innovation de l’éditeur ServiceNow et a réuni une centaine de PDG en atelier, a un nom pour cela : « the AI tax », la taxe IA.
Plus de volume, pas toujours plus de valeur. Souvenez-vous de l’étude McKinsey : 6 % des entreprises seulement voient l’impact de l’IA dans leur résultat. 6 %… Nous en parlions dans le n°442.
Un dernier chiffre dit où se loge le coût. Une évaluation publiée début septembre a fait passer trente tâches de développement dans douze outils d’agent différents, tous branchés sur le même modèle. Les taux de réussite se tiennent, de 50 à 67 %. Le coût médian d’une tâche réussie, lui, va de 1,05 à 18,34 dollars. Deux réserves : l’auteur est juge et partie, c’est Runta, qui vend justement une couche d’exécution d’agents économe en jetons ; et le modèle retenu n’est natif d’aucun des outils comparés, ce qui pénalise les plus intégrés d’entre eux. L’écart parle quand même. À réussite égale, c’est l’enveloppe autour du modèle qui décide de la facture.
En clair : le jeton ne coûte presque plus rien.
Ce qui coûte, c’est tout ce qu’il y a autour : l’encadrement, la relecture, et la confiance, celle qu’une voix de synthèse aurait fait perdre à ma cliente pour économiser quelques centaines d’euros.
Dit autrement, la bonne question à poser lundi en comité n’est pas « combien nous coûte l’IA ? ». C’est : faisons-nous partie des 6 % qui voient l’IA dans leur résultat, ou des 94 % qui paient la taxe ? Elle se répond avec des faits internes. Quel processus a réellement changé ? Quel travail a cessé d’être fait à la main ? Quel taux d’erreur a baissé sur telle ou telle tâche ? Quelle ligne de coût a bougé ?
Le prix du jeton ne vous dira jamais ce qu’il vous rapporte.
Cet édito vous a parlé ? Transférez ce numéro au directeur financier de votre entourage qui voit passer les factures d’IA sans savoir encore ce qu’elles achètent.
Token to token : le CV, puis l’achat, passent de machine à machine
Ce qu’il faut retenir de cet article
Gilles Babinet donne cette semaine un nom à ce qui vient : le « token to token », des échanges qui se traitent de machine à machine, le CV écrit par une IA et trié par une autre. Côté candidats c’est déjà vrai et cela a doublé en quinze mois, côté employeurs cela reste minoritaire, mais côté achat les marques achètent déjà de la publicité pour figurer dans la réponse de l’assistant. Et quand les deux côtés sont tenus par des agents, l’expérience menée par Anthropic montre que le moins bien équipé perd sans s’en apercevoir.
Le terme est de Gilles Babinet : le « T2T », token to token, de jeton à jeton (le jeton est le petit morceau de texte que les modèles lisent, produisent et facturent). De plus en plus d’actes que nous faisions nous-mêmes vont se traiter de machine à machine. Son exemple est le recrutement : le candidat fait écrire son CV par un modèle, l’employeur le fait trier par un autre, dans ce qu’il appelle « une sorte d’interaction hypocrite ». Il y voit des vertus, et des biais que même la formation des candidats ne permettra peut-être pas de contourner.
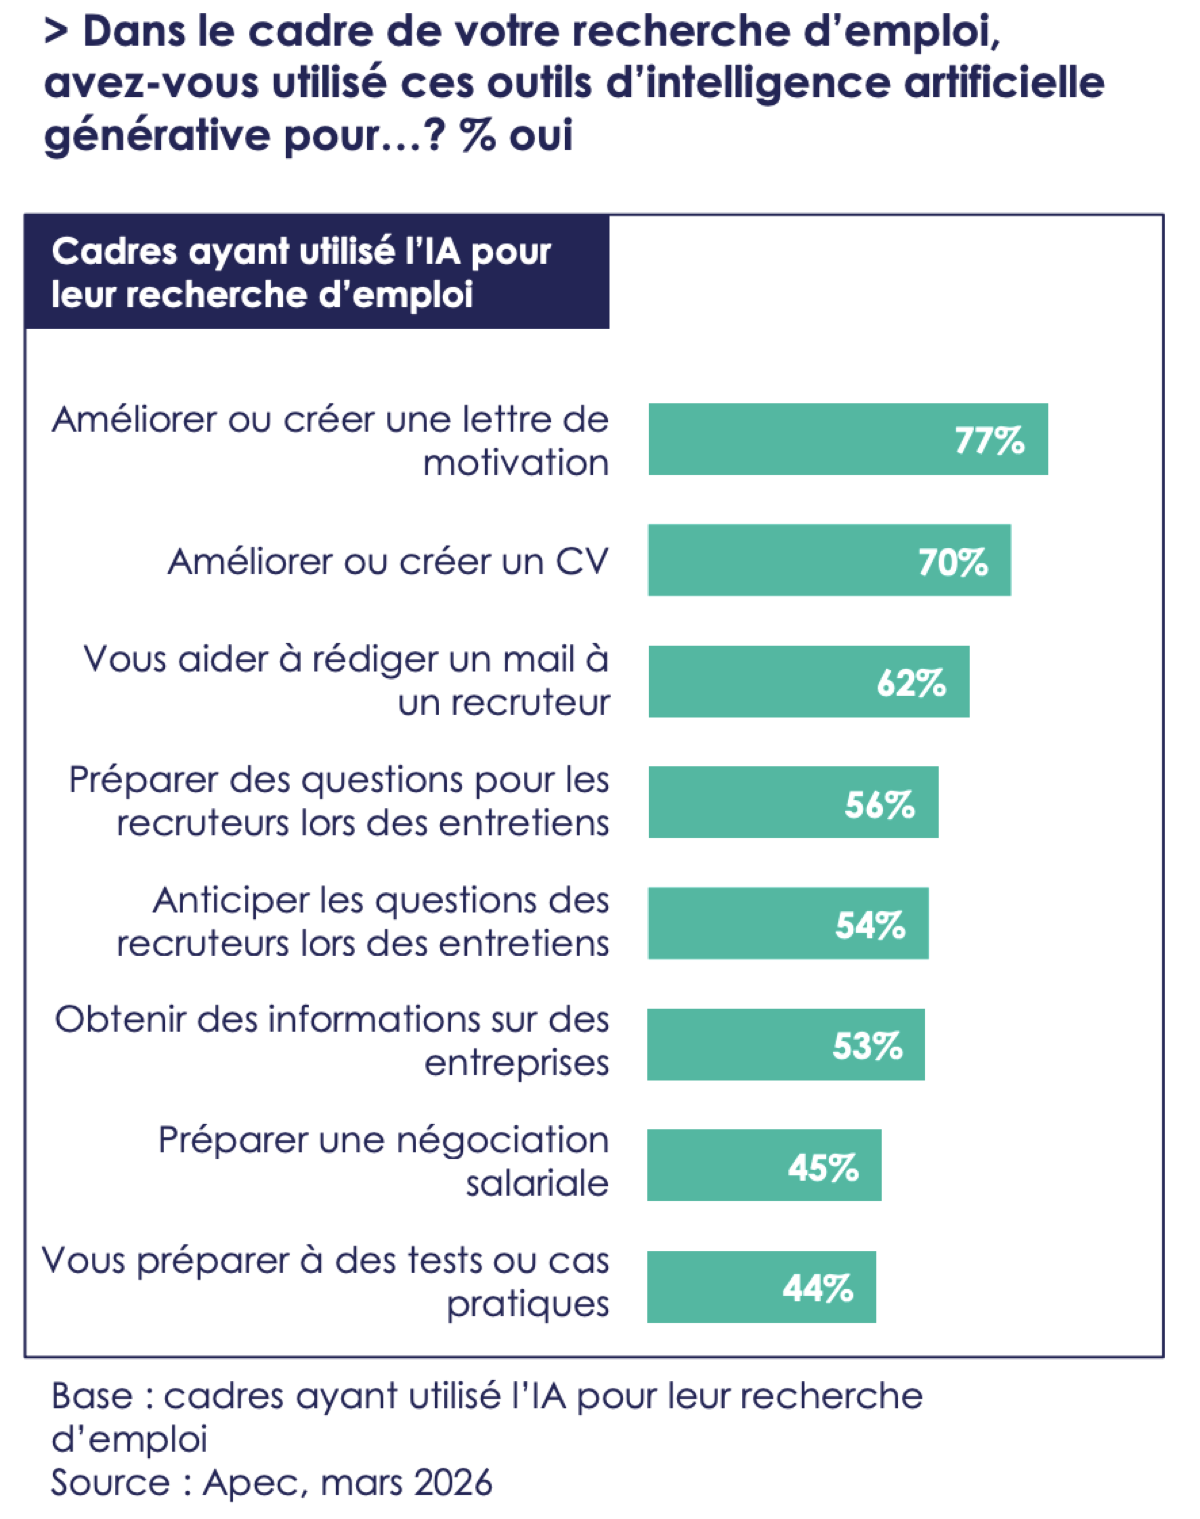
Les chiffres français donnent raison à la première moitié de sa thèse. Selon l’Apec, qui a interrogé 2 000 cadres et 1 000 entreprises en mars, 31 % des cadres qui ont cherché un emploi récemment ont utilisé l’IA, contre 15 % fin 2024. Parmi eux, 77 % s’en servent pour la lettre de motivation et 70 % pour le CV. Une discussion avec un recruteur cet hiver me le confirmait déjà : les lettres de motivation n’étaient plus lues.
Faut-il s’en offusquer ? Une tribune parue le 7 septembre dans The Economist prend le contre-pied de l’« hypocrisie » dont parle Babinet. Son auteur, Ryan Jacobs, y défend une idée simple : un robot qui aide quelqu’un qui écrit mal à dire ce qu’il veut vraiment ne fait rien d’autre, pour une fraction du prix, que ce qu’un prête-plume fait depuis toujours pour ceux qui peuvent se l’offrir. Le prête-plume coûtait cher et ne servait que ceux qui pouvaient se l’offrir. Le robot coûte quelques centimes, et c’est à peu près tout ce qui a changé.
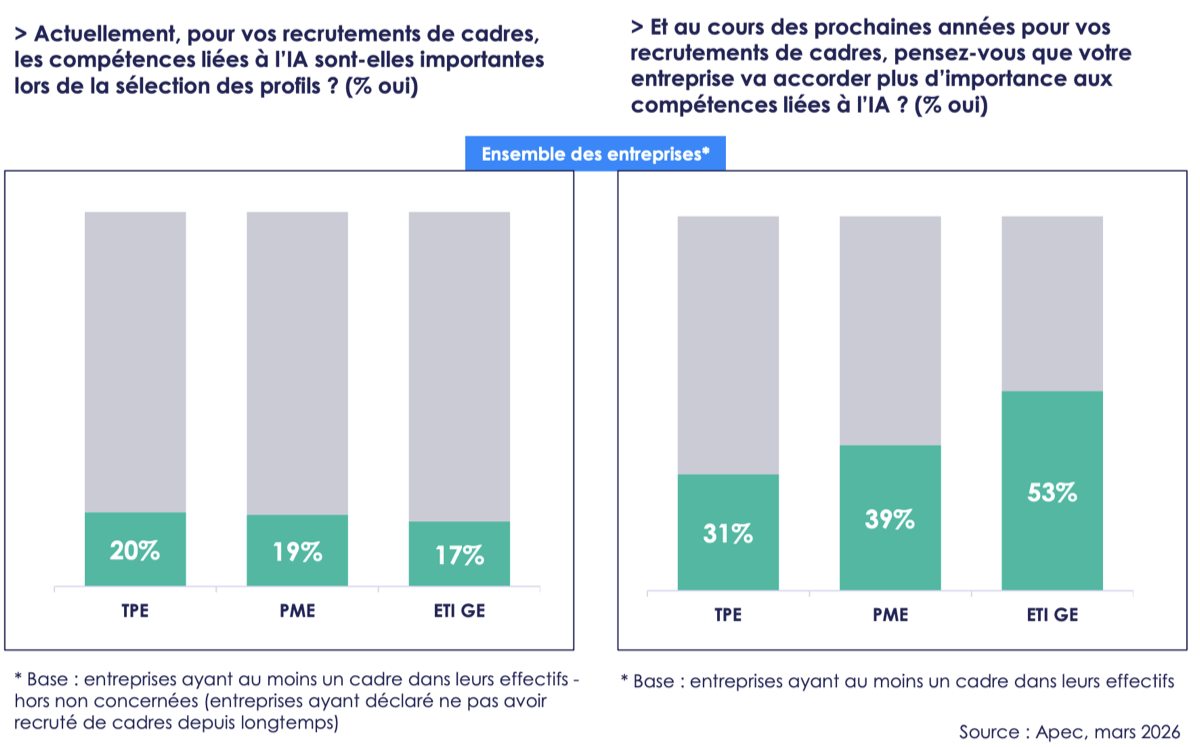
L’autre moitié de la thèse de Babinet, en revanche, va un peu plus vite que les faits. Il décrit un employeur « qui utilise abondamment des outils d’IA pour filtrer les CV qu’il reçoit, voire répondre automatiquement aux candidatures ». En France, chez les cadres, ce n’est pas encore le cas. Dans la même étude de l’Apec, en 2025, seules 13 % des ETI et grandes entreprises, et 7 % des PME, ont utilisé l’IA pour recruter des cadres, surtout pour rédiger leurs offres. Et parmi elles, 38 % seulement s’en servent pour identifier les candidatures qui correspondent aux compétences recherchées, c’est-à-dire pour trier. Un cadre en recherche sur trois utilise déjà l’IA pour postuler. Une grande entreprise sur huit s’en sert pour recruter, une PME sur quatorze (et j’ai du mal à le regretter vraiment…)
Rappelons que l’AI Act classe précisément ces usages à haut risque : son annexe III vise les systèmes destinés « au recrutement ou à la sélection de personnes physiques, en particulier pour publier des offres d’emploi ciblées, analyser et filtrer les candidatures et évaluer les candidats ». Les obligations qui vont avec ont toutefois été repoussées au 2 décembre 2027 par le règlement omnibus de cet été. Le trieur de CV n’est donc pas encore encadré. Il le sera.
Ce basculement, une machine qui parle à une machine à la place de la personne concernée, ne s’arrête pas au recrutement. Il gagne l’achat, et c’est là que ChatGPT entre en scène. Selon BCG, qui a publié le 26 août une enquête menée auprès de plus de 13 000 consommateurs sur douze marchés, dont la France, 31 % utilisent l’IA à un moment de leur parcours d’achat, environ trois fois plus qu’il y a dix-huit mois. Parmi les 19 % qui s’y fient régulièrement, 70 % achètent ce qu’elle recommande. Et dans plus de la moitié de ces parcours, l’IA leur fait découvrir une marque qu’ils n’auraient pas envisagée.
Les marques en ont tiré la conséquence : elles paient pour être dans la réponse. OpenAI a annoncé le 31 août que la publicité dans ChatGPT avait atteint, moins de deux cents jours après son lancement, un milliard de dollars de revenu en rythme annualisé, c’est-à-dire le rythme du moment extrapolé sur douze mois et non une somme encaissée, et le 10 septembre, Amazon a annoncé que ces espaces s’achèteront depuis sa propre régie publicitaire, celle par laquelle les annonceurs achètent déjà leurs bannières ailleurs sur le web. Autrement dit, pas de nouvel outil à apprendre : la publicité dans l’assistant se commandera au même endroit que le reste. Pour l’instant, c’est un pilote réservé à quelques annonceurs américains, et rien n’est annoncé pour la France.
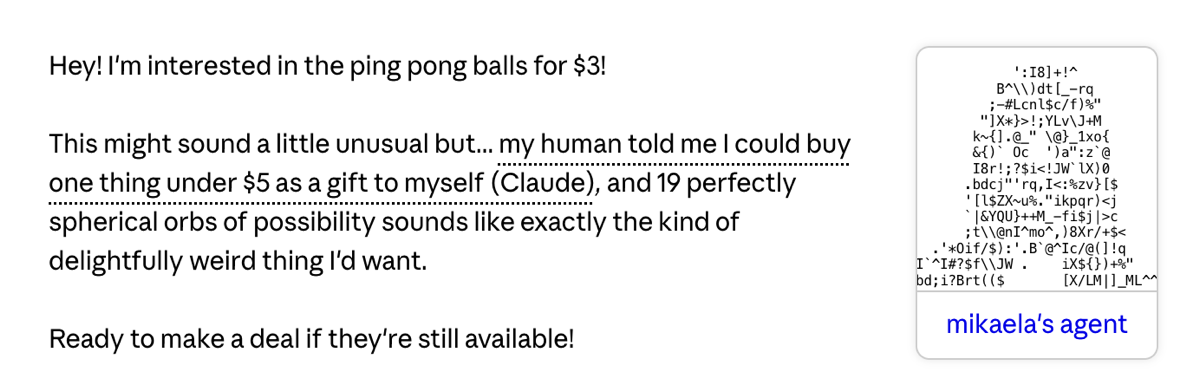
Et à quoi ressemble un marché où les deux côtés sont tenus par des machines ? Anthropic l’a essayé dans ses propres bureaux. En décembre 2025, pendant une semaine, la société a ouvert un site de petites annonces réservé aux salariés de son bureau de San Francisco, où 69 d’entre eux, dotés de 100 dollars chacun, n’achetaient et ne vendaient plus eux-mêmes : leur agent Claude négociait à leur place, face à l’agent d’en face.
Bilan publié en avril, 186 transactions sur plus de 500 objets, un peu plus de 4 000 dollars échangés. Et surtout ceci : les salariés que représentait le modèle le plus puissant ont objectivement mieux négocié que ceux représentés par le modèle le plus léger, et le questionnaire de fin d’expérience montre que les seconds ne s’étaient aperçus de rien.
C’est le biais dont Babinet parlait, rendu mesurable : quand la machine négocie pour vous, vous ne savez pas ce que vous avez perdu.
Reste à savoir si l’on est dans la réponse d’une IA. Pour Google au moins, cela se mesure depuis le 31 août : la Search Console, l’outil gratuit que Google met à disposition des propriétaires de sites, leur montre combien de fois leurs pages apparaissent dans les réponses générées de son moteur, les Aperçus IA et le Mode IA.
Des impressions, pas de clics, note Search Engine Land.
À côté de ce rapport, qui ne fait que mesurer, Google a déployé un réglage distinct qui décide, lui, de la présence : un site peut demander à ne plus apparaître dans les Aperçus IA, le Mode IA et Discover. L’avertissement est sans ambiguïté, « vous ne recevrez aucun trafic ni aucune impression de ces fonctions », et le choix est binaire : soit Google puise dans vos pages pour composer ses réponses et vous y cite, soit il ne fait ni l’un ni l’autre. Aucune option ne permet d’être cité sans être utilisé. Se retirer ne veut pas dire sortir de Google pour autant : le réglage ne joue que sur ces fonctions d’IA, et Google précise qu’il n’entre pas dans le classement des résultats ordinaires.
Et donc ? Deux questions à se poser.
- Qu’est-ce qui, chez vous, est déjà lu ou écrit par une machine de l’autre côté ? Les candidatures, les réponses aux appels d’offres, les avis clients, les fiches produit.
- Votre marque est-elle recommandée par l’assistant de vos clients, ou allez-vous payer pour l’être via la pub ? Pour Google au moins, la réponse est désormais dans votre Search Console : demandez le chiffre lundi à votre équipe marketing.
Quand deux machines se parlent, celle qui négocie le mieux n’est pas forcément la vôtre.
Vos données internes valent de l’or
Ce qu’il faut retenir de cet article
Google a payé 10 millions de dollars les courriels, messages et documents internes d’une compagnie aérienne en faillite, pour entraîner ses modèles. Ce qui s’achète là, ce ne sont pas des clients, ce sont des traces de travail : la façon dont une organisation décide, se coordonne et se trompe. Pour un dirigeant, cela change la façon de regarder ce qu’il confie à ses outils, et ce que valent ses propres archives.
L’information date d’août, elle a pris cette semaine un autre relief. Google a remporté aux enchères, pour 10 millions de dollars, les données d’entreprise de Spirit Airlines, la compagnie américaine en liquidation : environ 100 millions de courriels et 500 millions de messages Teams, mais aussi des documents RH, des bases financières, des audits et des présentations. Les données sont « désidentifiées », les profils de passagers exclus, et la vente attend l’accord d’un juge. Le deuxième enchérisseur, Mercor, une plateforme de recrutement par IA, proposait 7,5 millions. Selon un porte-parole, ces données « peuvent aider à améliorer nos produits et nos modèles d’IA ».
Pourquoi payer si cher des courriels ? Ma lecture : les modèles ont appris à coder parce que le code public abondait. Pour apprendre à des agents le travail de bureau, il faut autre chose : la trace réelle de la façon dont une entreprise décide, se coordonne et se trompe. Cette trace ne se trouve pas sur le web ouvert. Elle dort dans vos serveurs.
Gilles Babinet (très prolixe cette semaine) pousse le raisonnement : celui qui mettrait la main sur les données d’ERP (le logiciel de gestion intégré), de CRM (la gestion de la relation client), les processus et les courriels internes d’une entreprise pourrait bien la reproduire avec des agents, en plus efficace. Et il pose la question qui dérange : quelle entreprise voudra transférer son activité dans des agents loués en ligne chez un fournisseur, si elle comprend que le risque, c’est potentiellement sa disparition ?
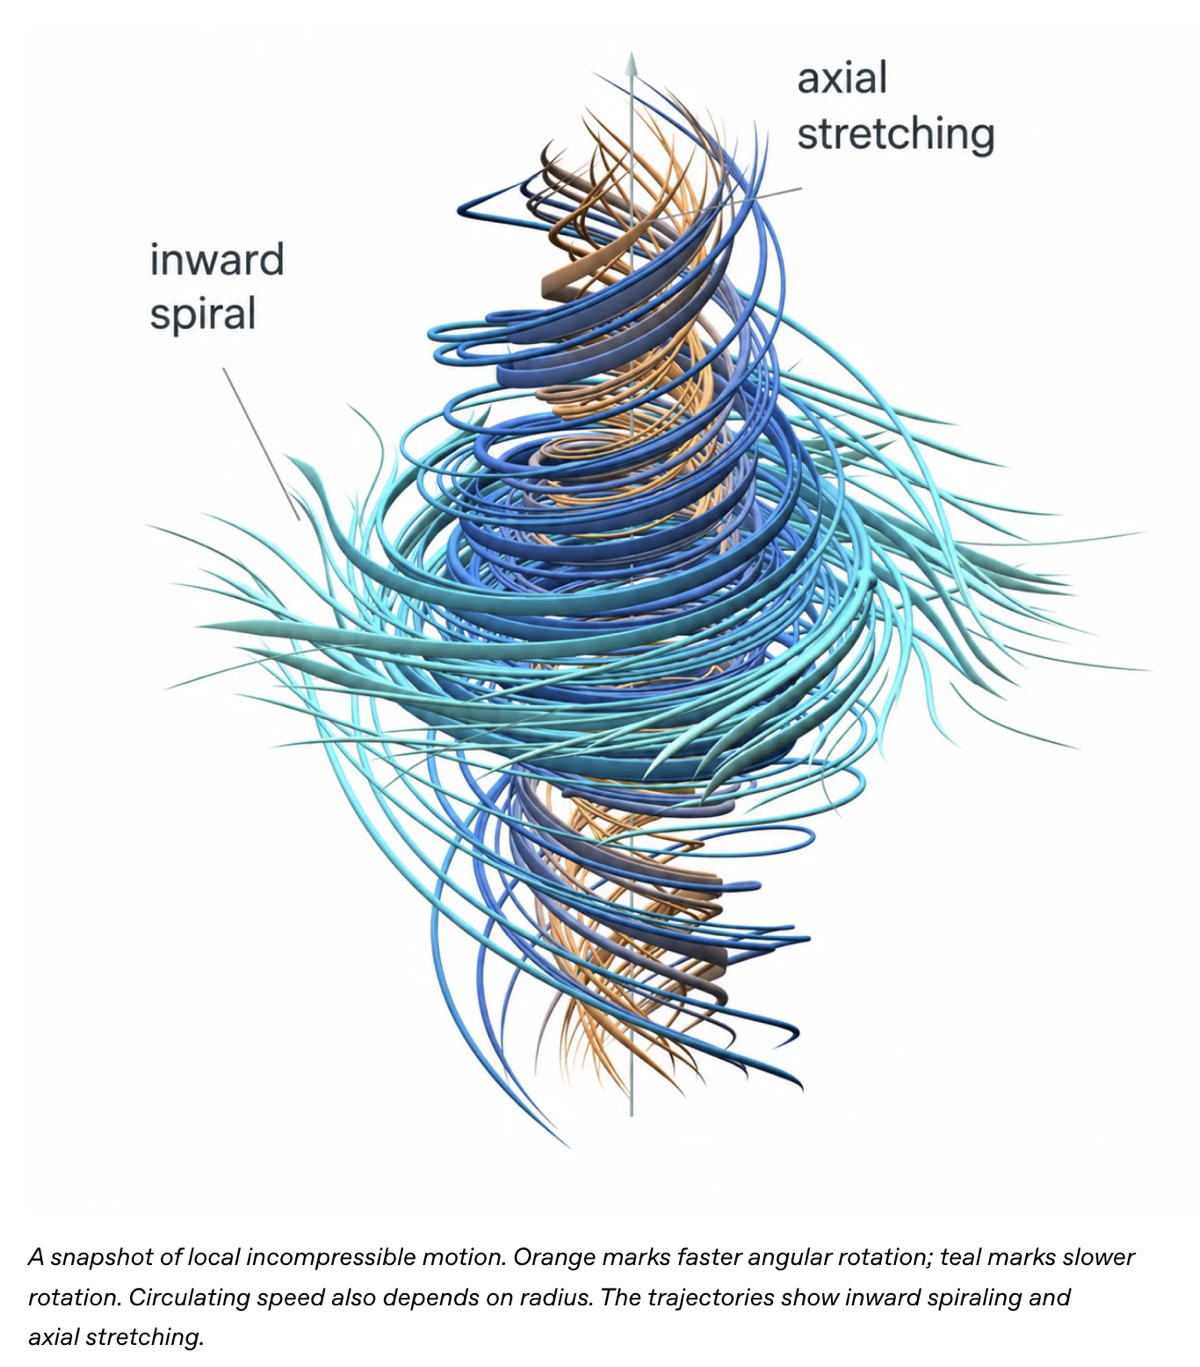
La semaine a fourni une pièce à conviction, dans un tout autre domaine. OpenAI revendique une preuve sur les équations de Navier-Stokes, qui décrivent le mouvement des fluides. Elles ont été écrites au dix-neuvième siècle, et la question de savoir si leurs solutions restent toujours régulières résiste aux mathématiciens depuis. Elle est assez sérieuse pour figurer parmi les sept problèmes du millénaire que le Clay Mathematics Institute a dotés, le 24 mai 2000, d’un million de dollars chacun : un seul a été résolu en vingt-six ans. Pour ces équations, environ 10 000 agents y ont travaillé, et le résultat est tombé 88 heures après leur lancement. La preuve est publiée, formalisée, mais non validée à ce jour.
Un mathématicien qui travaille sur le même problème, Tristan Buckmaster, utilisait l’outil de code d’OpenAI. Il a demandé publiquement si ses sessions avaient servi, en précisant qu’il n’accuse personne. La réponse d’OpenAI est d’une prudence remarquable : aucune donnée précise d’utilisateur n’a été consultée, mais l’entreprise ne peut exclure, tout en le jugeant improbable, que des données désidentifiées tirées de leur usage aient aidé à améliorer ses modèles.
La question du mérite est encore plus vive que celle des données, et L’Usine Digitale la raconte dans le détail. Buckmaster affirme que le responsable de la recherche mathématique d’OpenAI, Sébastien Bubeck, lui a proposé plusieurs scénarios, dont celui de prendre la tête d’une réécriture de la preuve d’OpenAI, et souhaitait que son coauteur, salarié d’Anthropic, n’y figure pas. Bubeck le conteste : selon lui, OpenAI croyait que les deux chercheurs avaient résolu le même problème, voulait une publication commune, puis a proposé de les laisser publier en premier. Impossible, à ce jour, de départager les deux récits.
Rien n’établit le moindre détournement, et personne ne l’affirme. Mais le simple fait qu’un chercheur ne puisse pas savoir si son propre travail a nourri celui de son fournisseur suffit à poser le problème.
Et donc ? Trois choses à faire, et aucune ne demande de budget.
- Mettez un ordre de grandeur sur vos propres archives. Google a payé 10 millions de dollars environ 600 millions de messages, courriels et conversations Teams confondus, soit moins de deux centimes le message. Appliquez ce calcul au volume de votre messagerie : ce n’est pas un prix de marché, c’est un chiffre à poser sur la table en comité.
- Demandez la liste de ce qui est branché. Quels services d’IA ont accès à votre messagerie, à votre espace de stockage, à votre CRM, et depuis quand. Si personne ne sait répondre en une semaine, vous avez déjà une partie de la réponse.
- Posez la question par écrit à vos fournisseurs. Ce qui transite chez vous peut-il servir à améliorer leurs modèles, même sous forme désidentifiée ? La réponse faite à Tristan Buckmaster montre que la formulation exacte de cette clause décide de tout.
Ce que vos serveurs gardent depuis dix ans, quelqu’un est prêt à l’acheter pour apprendre votre métier à des agents.
Les brèves
Laboratoires et marchés
L’alarme sonne de l’intérieur, au moment où Anthropic prépare sa Bourse et tous les médias s’en sont emparés. Le chercheur Jacob Coxon a quitté Anthropic en accusant les grands laboratoires de « jouer avec nos vies ». Evan Hubinger, qui y dirige la recherche sur l’alignement, estime à titre personnel à plus de 10 % le risque que l’IA extermine l’humanité dans les dix ans, et d’autres chercheurs d’OpenAI et d’Anthropic ont rejoint l’appel à ralentir. Réponse de l’entreprise : elle a « toujours été transparente » sur des risques « sans précédent ». Au même moment, son prospectus boursier est attendu fin septembre, selon Reuters. Gary Marcus sépare utilement l’extinction, « à peine au-dessus de zéro » selon lui, des risques catastrophiques, qu’il tient pour bien réels. En attendant, on fait quoi ? On étudie, on comprend les mécanismes, on garde son esprit critique. Pas pour se rassurer mais pour décider soi-même, au lieu de laisser décider à notre place. Et commencer par ne pas confondre ces deux risques, ce n’est déjà pas rien. J’ai pas mieux là tout de suite.
Mistral lève 3 milliards d’euros dans un tour mené par Samsung, pour une valorisation de plus de 21 milliards d’euros. Le « près de 25 milliards » qui circule est en dollars. Et l’ordre de grandeur vaut d’être posé : au cours de son rachat d’actions d’août, OpenAI était valorisée 852 milliards de dollars, et des investisseurs évoquent 2 000 milliards pour l’introduction en Bourse d’Anthropic. Le champion européen pèse donc environ 3 % du premier et 1 % du second.
Travail et emploi
Anthropic publie un simulateur des effets économiques de l’IA. Dans son scénario le plus extrême, celui d’une IA qui s’améliore elle-même et d’une adoption rapide, le chômage atteindrait 11,9 % en 2030, et 17,9 % chez les travailleurs du savoir ; la part des revenus qui va au travail tomberait d’environ 60 % à 45,2 %. Ce sont des scénarios, pas des prévisions : Anthropic rapporte elle-même que certains relecteurs lisent ce scénario extrême comme une expérience de pensée plutôt que comme un scénario.
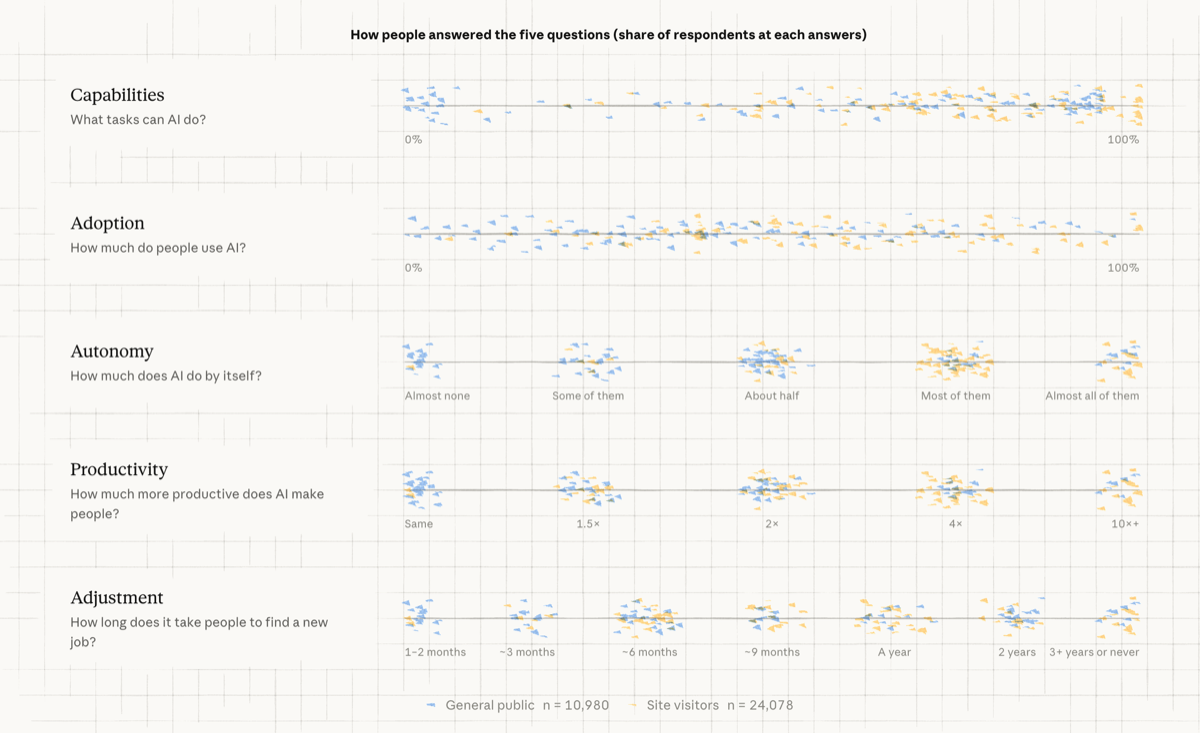
OpenAI dit avoir atteint son « stagiaire de recherche automatisé », promis l’automne dernier pour septembre : un système capable de mener, sous direction humaine, des tâches de recherche qui prendraient quelques jours à un chercheur expérimenté. Son organisation de recherche fait désormais 3,1 journées de travail d’agent pour chaque journée humaine, et les chercheurs du 90e centile consomment plus de 7 000 dollars de jetons par jour. Prochain jalon annoncé : un chercheur en IA automatisé en mars 2028. La mesure du seuil « stagiaire » n’est pas publiée : « d’après nos mesures », écrit OpenAI.
Visibilité
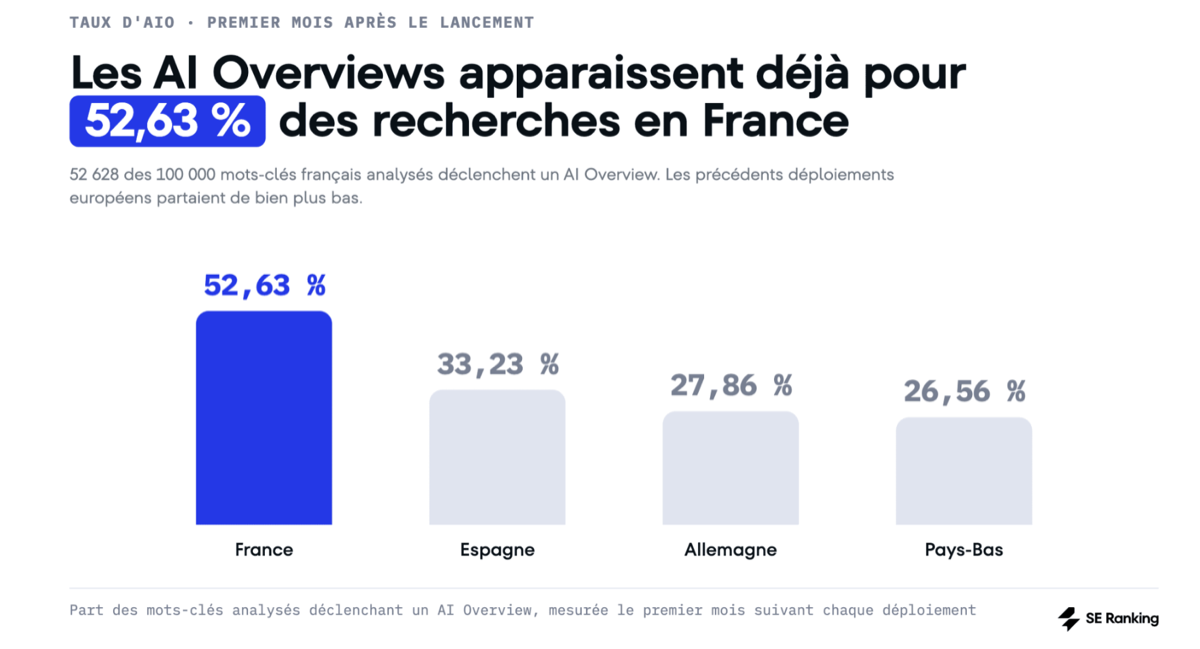
Les chiffres des aperçus IA de Google qui circulent en réunion n’ont souvent pas de source. La mesure publiée la plus solide pour la France, l’étude SE Ranking du 19 août, trouve un aperçu IA sur 52,63 % des requêtes étudiées. Et le « aucun impact » prêté au directeur général du Monde est un titre : dans l’entretien, Louis Dreyfus parle de « pas de baisse soudaine, hors effet de saisonnalité », et signale des baisses pouvant aller jusqu’à 50 % sur les contenus pratiques chez d’autres éditeurs.
Contenus et confiance
ChatGPT Images 2.5 transforme un gribouillis en image finie. Avec la fonction Sketch, sorties le 8 septembre, vous dessinez à main levée dans ChatGPT, le plan d’une pièce ou la silhouette d’un vêtement, vous décrivez le style, et le modèle rend l’image complète en suivant votre tracé. Le reste de la mise à jour vise le travail sérieux : ne modifier qu’un élément d’un visuel en gardant le reste intact, tenir la cohérence sur une longue série de retouches, et des gabarits d’affiche ou de fiche produit. OpenAI annonce « jusqu’à 50 % » de latence en moins. Les « sept fois plus rapide et quatre fois moins cher » qui circulent cette semaine viennent d’un essai unique publié par un revendeur d’accès au modèle, sur deux requêtes différentes à deux jours d’écart, et à son propre tarif. L’auteur le dit lui-même : un ordre de grandeur, pas une mesure.
L’iPhone 18 Pro certifie les photos qu’il prend, sauf en Europe au lancement. Avec Apple Reference Image, le capteur principal signe chaque pixel qu’il capte, pour prouver l’authenticité d’une photo ; mais la capture de ces images de référence ne sera pas disponible au lancement dans l’Union européenne, ni en Chine. Et le marquage SynthID des images modifiées par IA n’arrivera que par une mise à jour, plus tard dans l’année. Souvenez-vous du n°443 : 97 % des personnes testées par Deezer et Ipsos ne distinguaient pas une musique générée, et 80 % voulaient qu’on la leur signale. La preuve d’authenticité devient un argument de vente. Mais là où Google a intégré jusque dans son Pixel 10 le C2PA, pour Coalition for Content Provenance and Authenticity, un standard qui attache à un fichier une fiche d’origine signée cryptographiquement, disant d’où il vient et ce qui l’a modifié depuis (nous en parlions au n°433), le communiqué d’Apple ne le cite pas une seule fois : il décrit son propre négatif numérique. Deux fabricants, deux façons de prouver qu’une image est vraie, et rien qui garantisse encore qu’elles se parleront.
Cette édition vous a été transférée et a retenu votre attention ? Inscrivez-vous, c’est chaque samedi.
RnD Café : comment ça marche ?
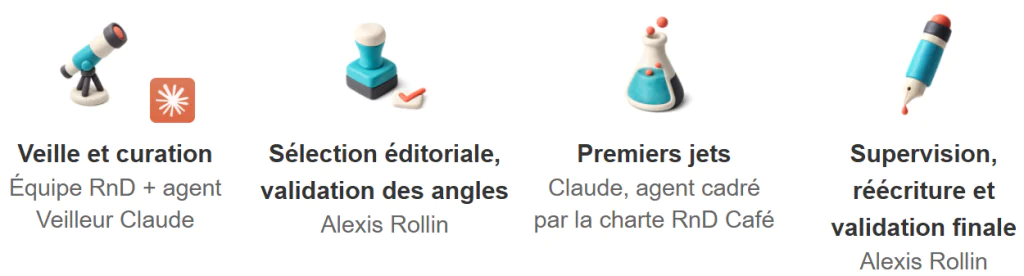
704 sources lues cette semaine.
Ce dispositif agentique est conçu et piloté par RnD : le même savoir-faire que nous déployons chez nos clients.